Un bon modèle ne suffit pas : encore faut-il savoir quand il cesse d'être bon.
L'objectif initial était classique : prédire la prime commerciale d'un contrat d'assurance auto. La partie la plus intéressante est venue ensuite, en confrontant les modèles à des données plus récentes : la dérive des données dégrade les performances bien plus vite qu'on ne l'imagine.
Démarche
- Analyse exploratoire pour identifier les facteurs qui pèsent sur les primes : âge du véhicule, coefficient bonus-malus, âge du conducteur.
- Deux familles de modèles : des GLM (Tweedie, Gamma) pour l'interprétabilité, LightGBM pour la performance brute, comparés sur RMSE, MAE, R² et MAPE.
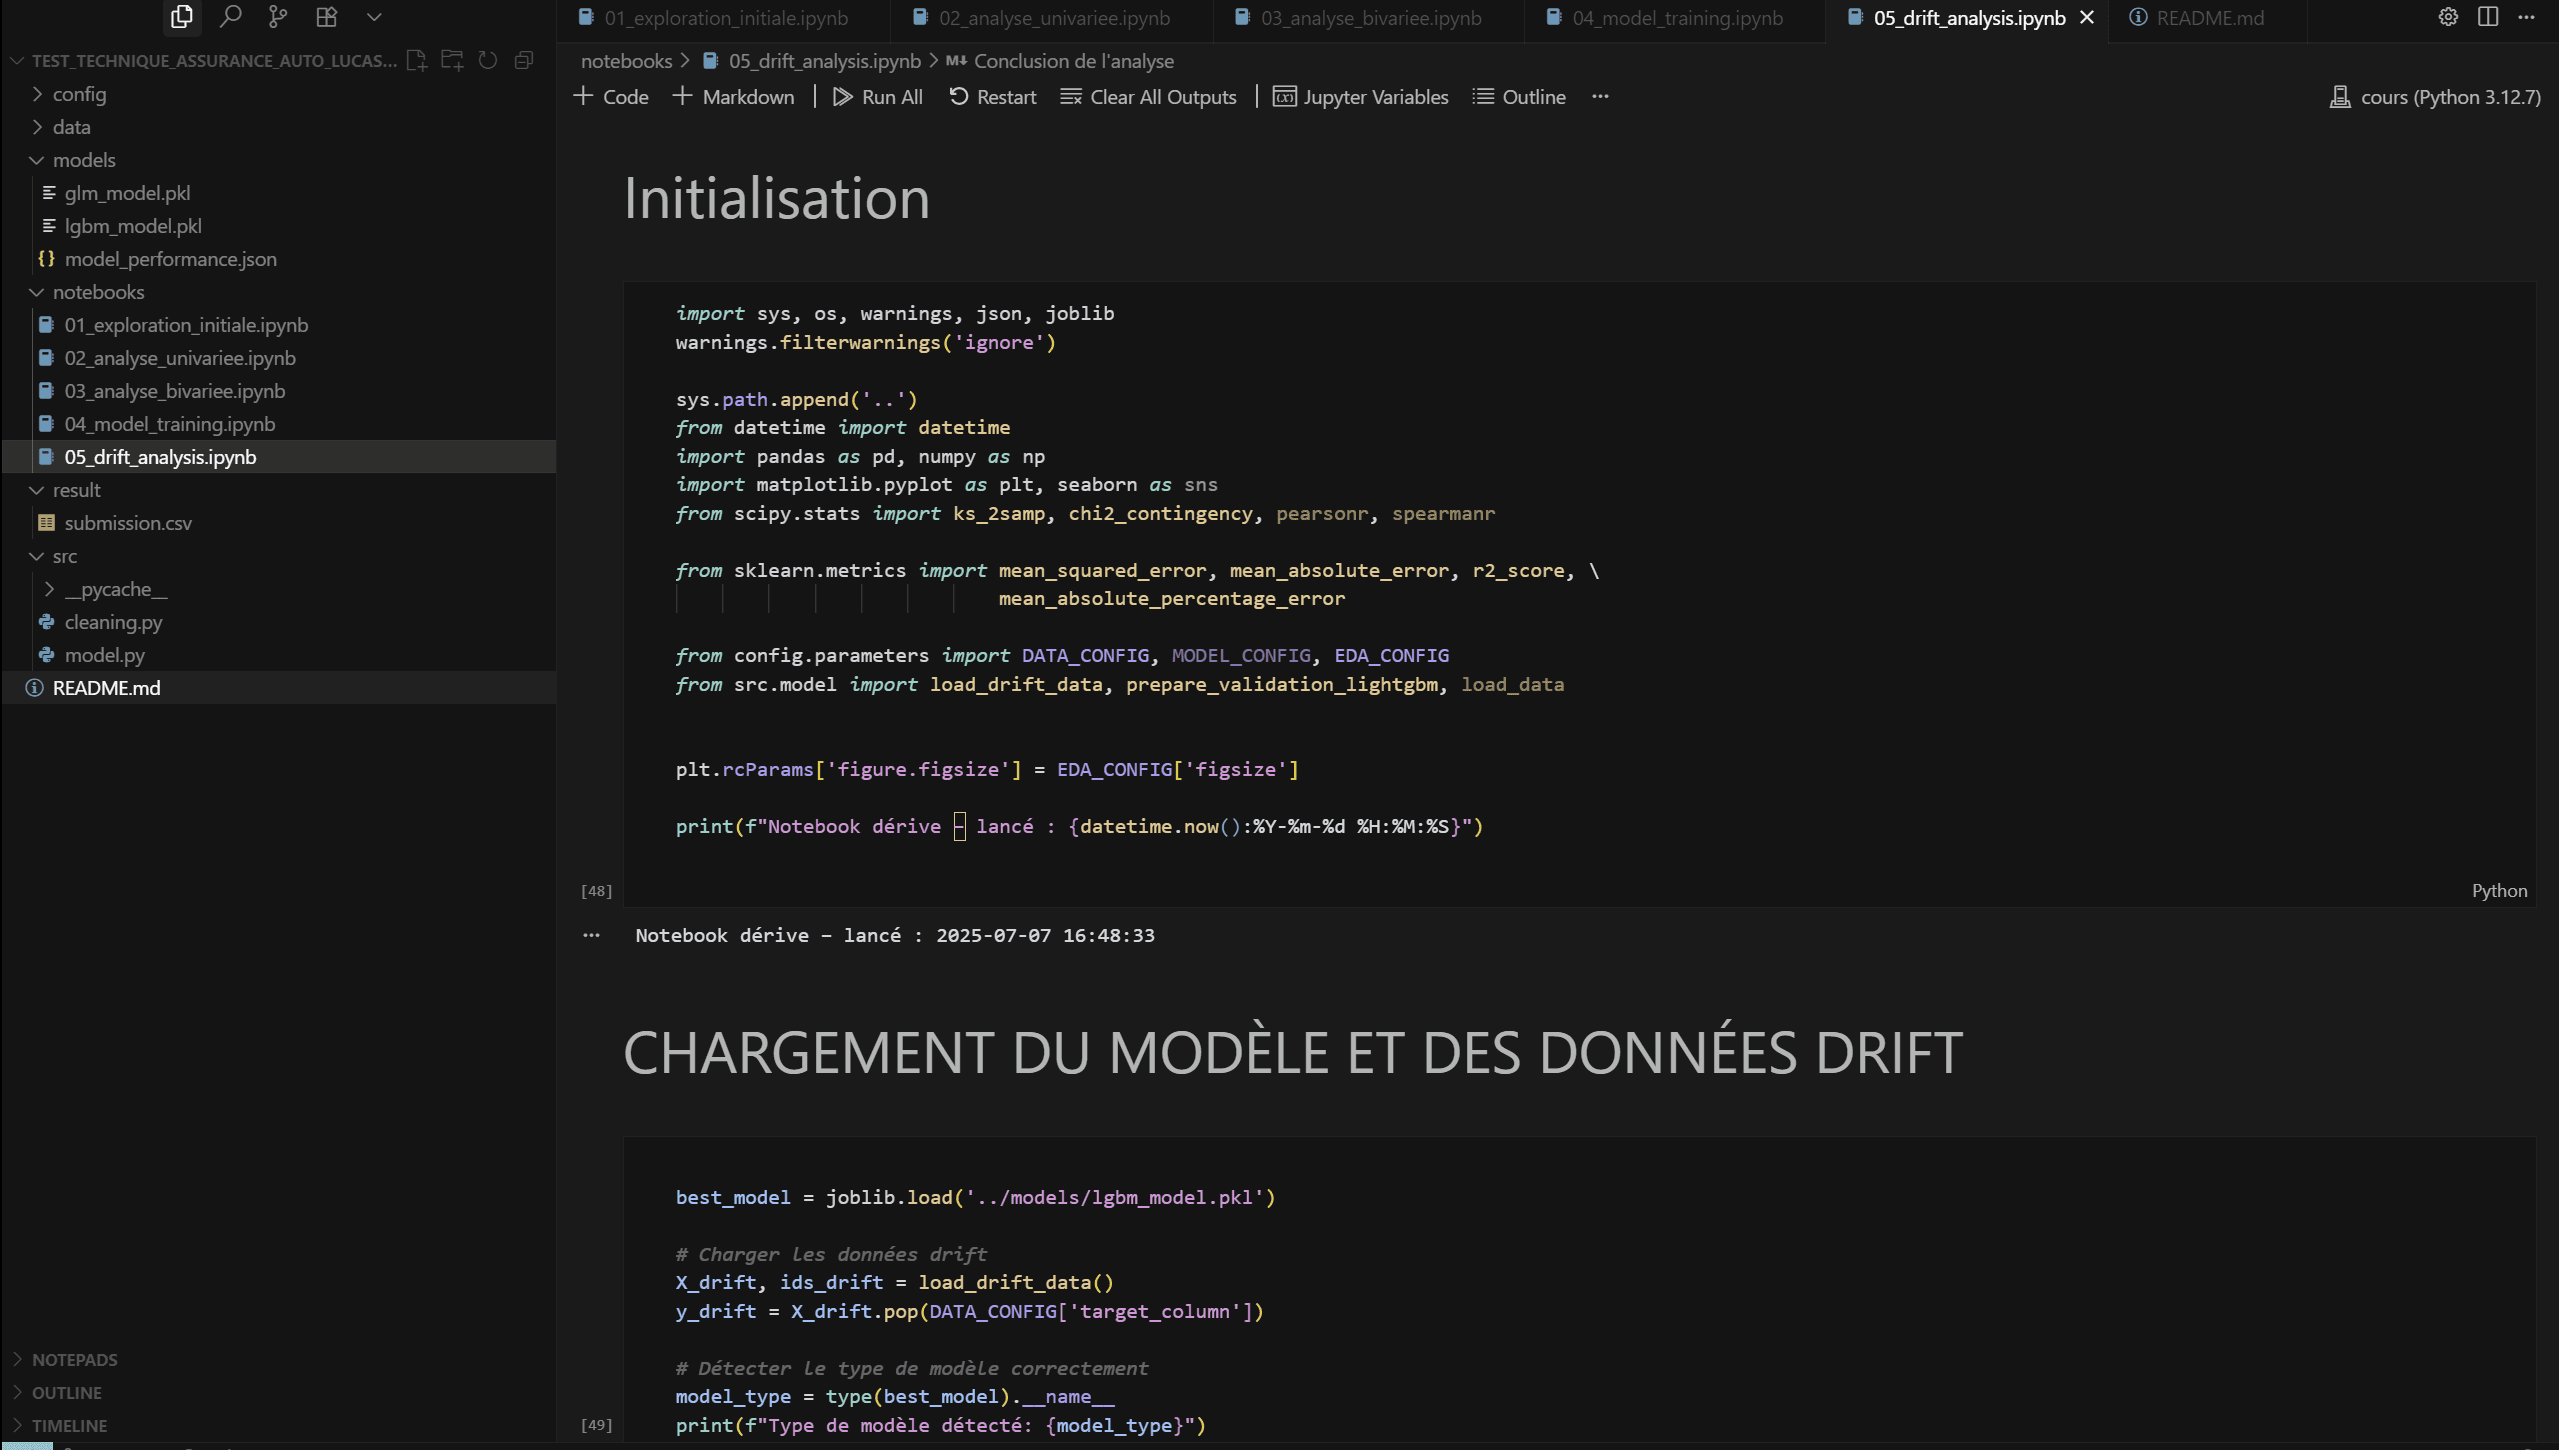
- Pipeline reproductible : nettoyage, entraînement, évaluation, puis analyse de dérive sur des données postérieures.
Ce que la dérive a révélé
Sur les données récentes, 45 % des variables clés avaient changé de distribution. Conséquence directe : le RMSE augmente de 147 % et le R² passe de 0,75 à -0,35, autrement dit le modèle devient pire qu'une simple moyenne. Les changements de profils des conducteurs (âge, bonus-malus) pèsent bien plus que les caractéristiques statiques des véhicules.
Recommandations
- Monitoring continu des distributions d'entrée et des métriques en production.
- Réentraînement périodique déclenché par des seuils de dérive, plutôt qu'à date fixe.
- Interprétabilité et performance ne s'opposent pas : garder un GLM comme référence lisible à côté du modèle de boosting.
Stack
Python, Pandas, NumPy, Scikit-learn, LightGBM, Statsmodels, Matplotlib et Seaborn.